最近在翻 Codex Harness 原始碼的時候,看到 Codex 對 Skill 的載入有自己的一套機制。這讓我有點好奇,不同的 Harness 又是怎麼處理 Skill 載入的?
所以我去深挖了幾個比較熱門的 Agent,包括 Codex、Claude Code、Pi、DeepSeek Harness、Hermes Agent 和 OpenClaw,看看它們背後的 Harness 各自是怎麼處理 Skill 載入的。
先從 Codex 開始
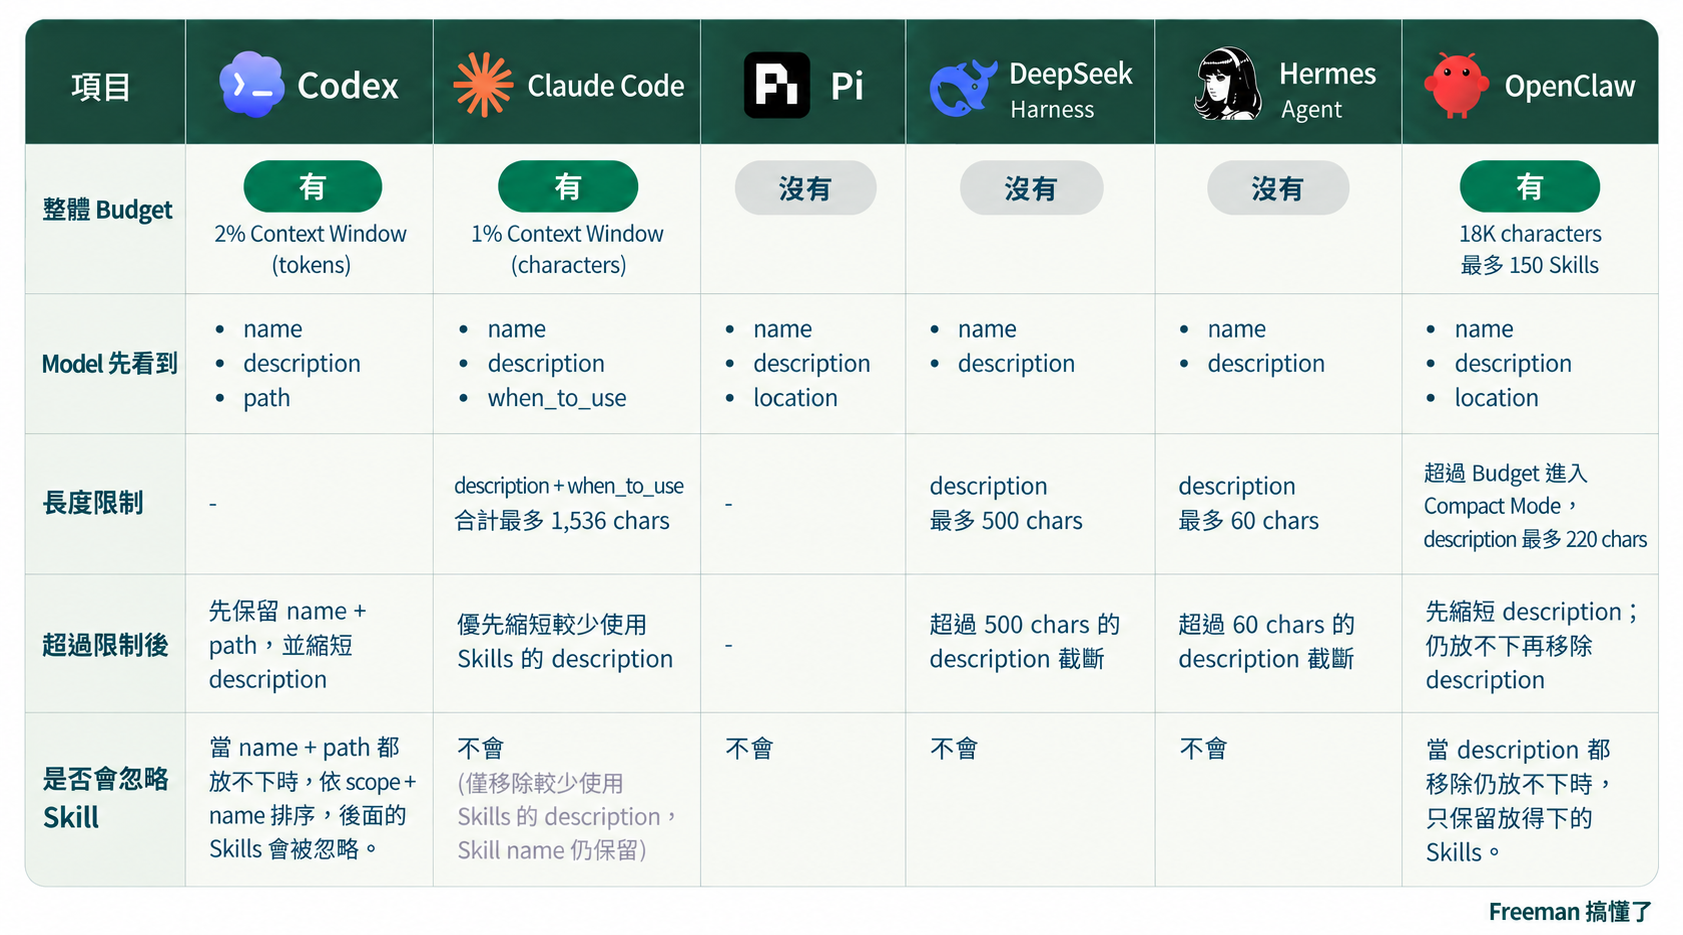
Codex 不會一開始就把完整的 SKILL.md 放進 Context,而是先提供 Skill 的 name、description 和 path,讓 model 判斷目前的任務需要哪些 Skill,再去讀取完整內容。
這些 Skill metadata 也不是無限制放進 Context。預設的 budget 是 Model Context Window 的 2%,也可以透過設定檔裡的 skills.max_context_tokens 自行調整,最高上限是 10,000 tokens。
當超過這個 budget 時,Codex 會先保留每個 Skill 的 name 和 path,剩下的空間再用 round-robin 的方式分配給 description。粗略地理解,就是較短的 description 比較容易完整保留,較長的則會從後面開始被截斷。
如果 Skill 數量繼續增加,連所有 name 和 path 都超過 budget,Codex 就會依據 scope 和 Skill name 排序,取到 budget 滿為止,後面的 Skills 則會被忽略。
其他 Harness 怎麼做?
多少 Skills 才需要開始注意?
雖然現在的 Model 已經支援很大的 Context Window,但能放得下,不代表 Context 越多越好。Long-context 的相關研究也一直指出,隨著資訊量增加,Model 不一定能穩定地利用所有資訊。
所以我自己還是習慣控制 Context 的大小。以 272K 作為一個基準,Codex 預設 2% 的 Skill metadata budget,大約就是 5,440 tokens。
我拿幾套熱門的 Skill package 粗略估算,Skill name 約 17 字元、description 約 150~200 字元,再加上約 50 字元的 path。以這個長度來看,100 個 Skills 已經會開始接近這個 budget。
而且 Skill 越多,不只是占用更多 Context,也代表 Model 要從更多候選項目裡判斷該使用哪一個。尤其當 Skills 之間功能相似或重疊時,我不認為全部留下來一定比較好。
所以我會把 100 個 Skills 當成一個檢查點。不是超過 100 個就一定會出問題,而是到了這個數量,我會開始檢查並移除不需要或功能重疊的 Skills。
最後
現在幾乎每天都有新的 Skill 出現,各種熱門的 Skill package 和整理好的工作流也越來越多。但從前面的機制可以看到,Skill 並不是裝得越多越好。很多 Skills 本身就有重疊的功能,全部裝進去,只是讓 Model 多了更多相似的選項需要判斷。
所以我看到新的 Skill,還是會先安裝使用看看。如果真的好用,我會拿它跟自己現有功能相近的 Skill 比較,再把其中更好的做法整理進自己的 Skill package。
References
- OpenAI Codex: https://github.com/openai/codex — 主要參考
codex-rs/ext/skills/src/render.rs、codex-rs/config/src/skills_config.rs與codex-rs/core/config.schema.json - Anthropic Claude Code: https://github.com/anthropics/claude-code
- Claude Code Skills Docs: https://code.claude.com/docs/en/skills —
Skill descriptions are cut short段落:1% listing budget、1,536-character entry cap 與 overflow 行為 - Pi: https://github.com/earendil-works/pi — 主要參考
packages/coding-agent/src/core/skills.ts - DeepSeek Harness: https://github.com/deepseek-ai/deepseek-harness — 主要參考
packages/skill/tool-skill - Hermes Agent: https://github.com/NousResearch/hermes-agent — 主要參考
agent/skill_utils.py、agent/prompt_builder.py - OpenClaw: https://github.com/openclaw/openclaw — 主要參考
src/skills/loading/skill-prompt-limits.ts、src/skills/loading/skill-contract.ts