如果你用過 Codex、Claude Code 這類 Coding Agent,其實你早就在使用 Harness。
我們平常很容易把注意力放在 Model 上:GPT、Claude、DeepSeek 哪個比較強?但 Model 只是 Agent 的其中一部分。它怎麼讀取專案、使用工具、執行指令、保留任務狀態,甚至怎麼決定下一輪要讓 Model 看到哪些資訊,這些都不是 Model 自己完成的。
可以先用一個簡單的方式理解:
Agent = Model + Harness
Model 負責推理與決定下一步;Harness 則負責把 Model 放進一個可以實際工作的環境裡。
也因此,即使用的是同一個 Model,換一套 Harness,最後的工作方式和結果也可能不一樣。
這篇不打算替 Harness 定一套標準規格。不同 Harness 的設計差很多,有些很精簡,有些已經把大量能力整合好。這篇比較想整理的是:現在我們使用 Codex、Claude Code 這類 Agent 時,Model 外面的 Harness 大致替我們處理了哪些事情。
Harness 到底包含哪些東西?
Harness 沒有一套所有產品都遵循的標準架構。Codex、Claude Code、Pi 或其他 Agent,實作方式都不太一樣。
我把現在常見的 Harness 組成整理成下面這張全景圖:
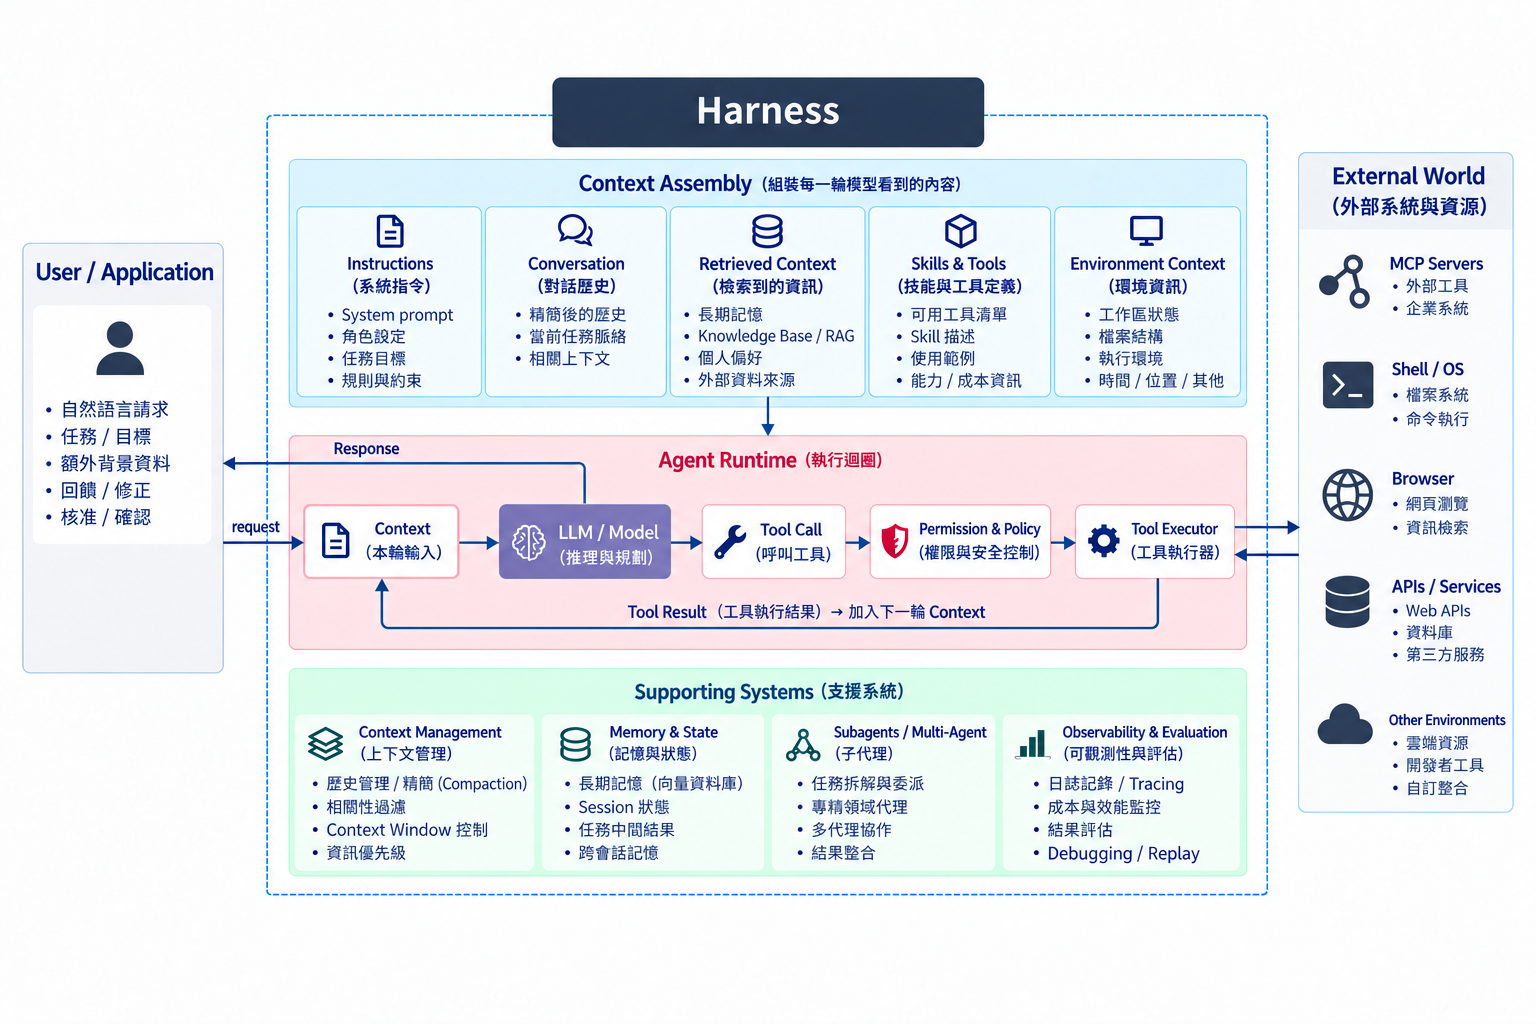
接下來我會從一次 Model request 怎麼被準備出來開始,順著這張圖走一遍。
Model 本身其實只看到這一輪給它的內容
我們平常使用 Coding Agent,很容易產生一種感覺:它知道整個專案、知道前面發生過什麼,也知道自己有哪些工具可以用。
但這些東西不是 Model 自己天然就知道。
在每一次 Model request 之前,Harness 都會先組裝這一輪要給 Model 看的 Context。
裡面可能包含:
- System instructions、角色設定與任務規則
- 使用者目前的需求
- Conversation history
- 從 Memory 或其他資料來源取得的資訊
- Skills 與可用工具的相關資訊
- Repository、工作目錄、環境或其他執行資訊
所以 Model 每一輪真正看到的,不是 Harness 擁有的全部資訊,而是 Harness 在這一輪替它組裝出來的 Context。
至於哪些資訊會被放進來,會依不同 Harness 的設計而有所不同。
Agent Loop:Model 不是一次把事情做完
Model 本身不會真的去操作電腦。它負責判斷下一步要做什麼,真正的動作則由 Harness 提供的 Tools 執行。
我覺得 Agent Loop 比較重要的地方,不是它會一直循環,而是每一次執行的結果,都會變成下一次決策的一部分。Model 可以根據剛剛讀到的檔案、測試失敗的結果,或 API 回傳的資料,重新判斷下一步。
所以 Agent 並不是先想好完整流程,再一次把所有步驟跑完;而是在執行過程中持續取得環境的回饋,再調整下一步。
這也代表 Model 的能力並不等於 Agent 最後能做到的事情。同一個 Model,Harness 提供的 Tools、執行環境和權限不同,最後能完成的任務也會不同。
任務變複雜後,光有 Agent Loop 還不夠
Agent Loop 解決的是「做一步、看結果、再決定下一步」。但當任務開始變長、變複雜,只靠這個循環很快就會碰到其他問題。
Context 越來越長,需要管理哪些資訊還要繼續保留;任務跨越多個 Session,需要保存目前做到哪裡;有些資訊希望之後還能再次使用,就會需要 Memory。
任務再大一點,也可能透過 Subagents 把不同工作拆開處理。當 Agent 開始長時間自主執行,Observability 和 Evals 也會變得重要,因為你需要知道它做過什麼、哪裡出了問題,以及調整之後到底有沒有變好。
這些都可以看成 Harness 周圍的 Supporting Systems。
不同 Harness 整合這些能力的程度差很多。像 Pi 可以從比較精簡的核心開始,再透過 Extension 或 Package 加上需要的能力;Codex、Claude Code 這類產品,則已經替使用者整合了更多能力。
這也是為什麼即使用的是同一個 Model,換一套 Harness,最後的工作方式和結果也可能不一樣。