我做過好幾套 Second Brain,最後幾乎都變成垃圾場。
Apple Notes、Evernote、各種 Web Clipper、Notion 都用過,其中 Notion 用得最多,前後甚至換過兩三套不同的 Second Brain Template。每一套都有自己的分類方式,什麼東西該放哪裡、筆記怎麼整理、資料之間怎麼建立關聯。
但當資料越來越多之後,最後都碰到相同的問題:就像有囤物癖的家一樣,堆滿了東西,想找的時候找不到,也沒有真的發揮這些內容的價值。
後來我開始嘗試把 AI 加進來。
從年初開始,慢慢把 Second Brain 搬到 Obsidian 上,一邊使用、一邊摸索適合自己的整理方式。前陣子又看到 Andrej Karpathy 分享的 LLM Wiki,納入其中一部分想法,再結合自己原本的做法,最後整理成目前這套結構。
我目前的 Second Brain 結構
目前整套 Second Brain 分成六個部分:
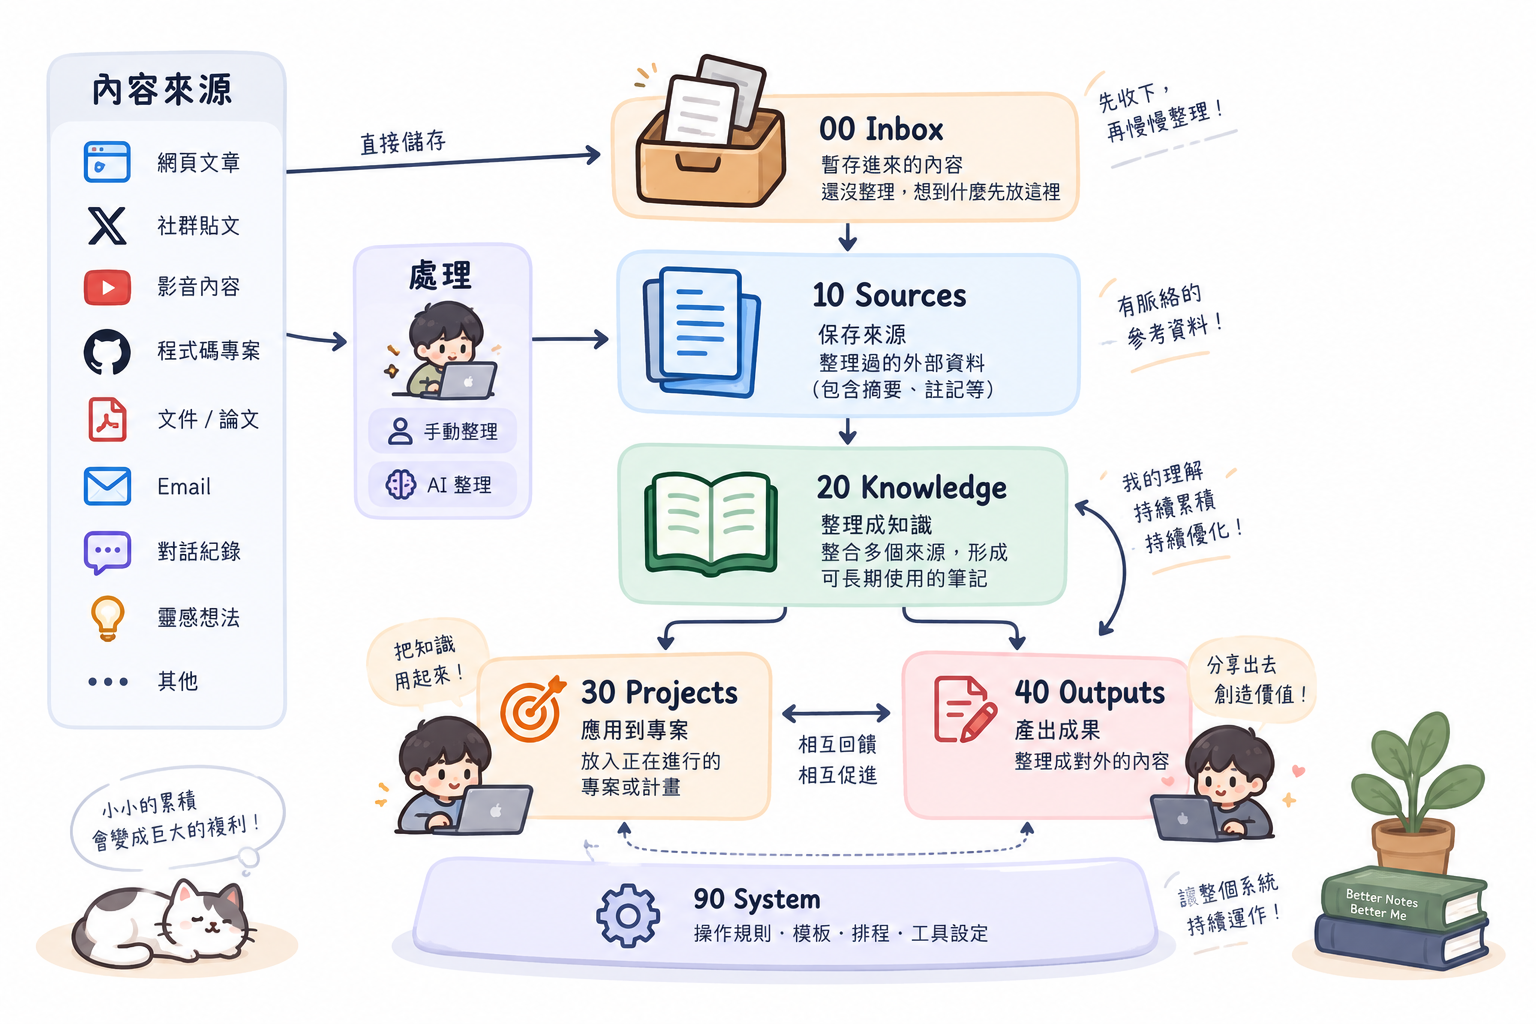
資料進來後,還沒處理的先放進 00 Inbox;整理過、值得保留的外部資料進到 10 Sources,再從累積的 Sources 中整理出可以持續更新的 20 Knowledge。Knowledge 可以持續留在知識庫裡,也可以進一步用在 30 Projects 或整理成 40 Outputs。
90 System 不在這條資料流裡,它放的是整套 Second Brain 的規則、Workflow、Template 和維護方式,後面會再提到它怎麼讓不同的 AI Agent 用相同的規則維護這套資料。
為什麼我最後把資料放在 GitHub?
我平常會頻繁在桌機、筆電和手機之間切換,而 Obsidian 的資料是放在桌機裡,在桌機瀏覽器看到不錯的文章,可以直接用 Web Clipper 存起來,但換到筆電或手機就做不到,同時使用 ChatGPT 等工具時,也無法直接讀寫桌機裡的 Obsidian 資料,所以跨裝置、跨工具就成了我使用上最大的問題。
而我選擇的做法是保留 Obsidian 原本的資料格式和結構,把資料同步到 GitHub。這樣不管更換裝置還是工具,都可以使用同一份 Second Brain。
現在如果在手機上看到不錯的文章,我會直接分享到 ChatGPT 裡討論,整理完再透過我接上的 GitHub 寫入工具把結果存進 Repo。換到筆電時,同步 GitHub 就能拿到最新的 Second Brain,Codex 也可以直接讀寫本機同步下來的資料。需要使用 Obsidian 時,一樣可以直接打開這份資料,繼續使用 Obsidian 原本的瀏覽、連結和其他工具。
資料存進去之後,還要定期整理
我覺得定期整理是 Second Brain 最重要的一環。過去 Second Brain 最後慢慢變成垃圾場,很大的原因就是整理本身有一定的成本和難度,當資料量越來越大,只靠人的記憶去掌握哪些內容重複、哪些已經過時、哪些其實可以整理在一起,很難長期維持。
現在有了 AI,這部分的工作就可以交給 AI 協助處理。我的做法是每週讓 AI 整理一次 Second Brain,只處理最近新增、還沒有整理過的 Sources,再從中更新或建立 Knowledge,並保留兩者之間的來源關聯。
有了定期整理,Second Brain 就不再只是保存資料,而是讓累積的 Sources 持續變成可以使用的 Knowledge。
這套 Second Brain,我整理成 Skill 了
我把這套 Second Brain 的架構和給 AI 使用的規則整理成 second-brain-kit,放在 GitHub 上。如果你也想用相同的方式建立自己的 Second Brain,可以直接使用裡面的 setup-second-brain Skill。
安裝 Skill 後,直接告訴 AI:
使用 setup-second-brain 幫我建立一套 Second Brain。
接下來 AI 會確認你的 GitHub Repo 和存取權限,再建立 Folder Structure、AGENTS.md、Workflow、Schema 和定期整理的規則。詳細的安裝與使用方式都放在 Repo 的 README。
References
- Andrej Karpathy, LLM Wiki pattern: https://github.com/cmdblock/Karpathy-LLM-wiki/blob/master/LLM%20Wiki.md