Model 開始工作前,Codex 準備了什麼?
Codex 每次呼叫 Model 前,都會先組好這次 request。從原始碼來看,可以先拆成三個主要部分:Instructions、Input 和 Tools。
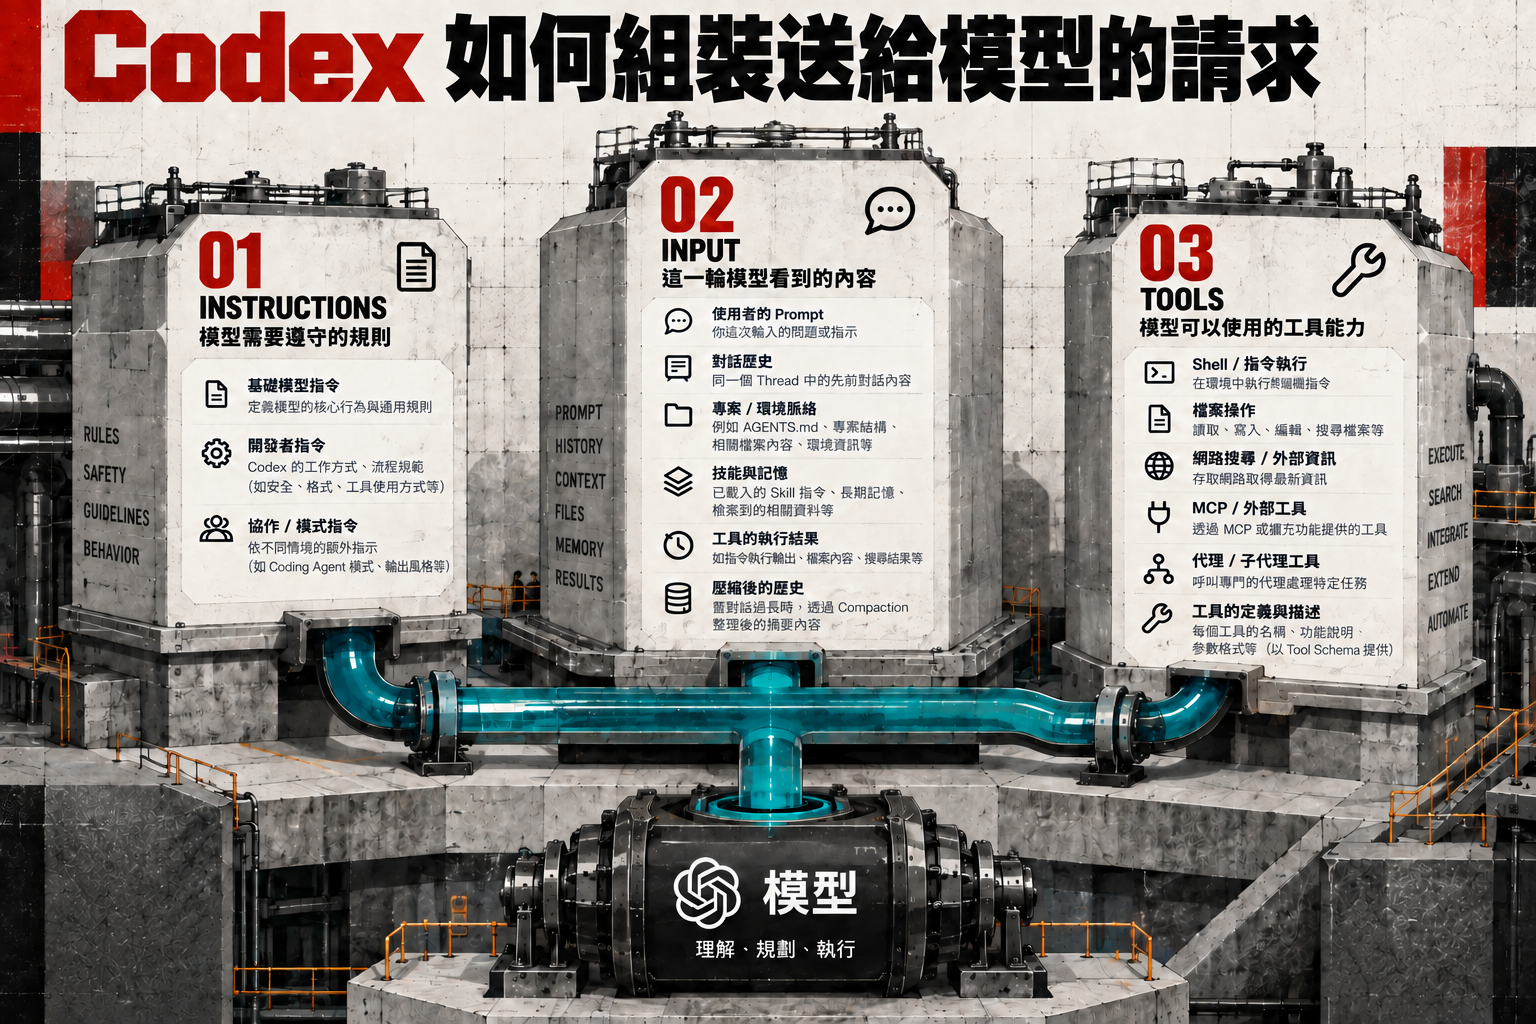
Codex Harness 對 Skills 有 Context Budget 的限制,當 Skills 太多時,部分 Skill metadata 可能不會被放進 Context。詳細的載入機制和數量限制,我另外整理在:Skill 越裝越多,AI Agent 還知道該用哪一個嗎?
長任務怎麼持續做下去?
Codex 中的一個對話稱為 Thread,隨著對話來回的次數增加,Context 也會持續累積,當接近 Model 的 Context Window 上限時,就會觸發 Compaction。此時 Codex 會用專門做 Compaction 的 Prompt,讓 Model 將目前的對話紀錄整理成一份 Summary,同時也會從對話紀錄中抽出 User Messages,從最新的訊息開始往前保留,直到觸碰到預設上限 20K tokens 為止。
Compaction 完成後,後續的 request 會用整理出的 User Messages 和 Summary 重新組成新的對話紀錄。因為 Compaction 通常發生在 Context 已經累積到相當大的時候,這時對話紀錄往往已經佔了很大一部分的 Input;重新整理後,原本這一大段 Cache 無法繼續命中,因此下一次 request 的 cached input rate 通常會顯著下降。
那 /goal 又是怎麼運作的呢?
/goal 有自己專門的 Continuation Prompt。這份 Prompt 會要求 Model 根據原本的目標和相關資料,整理出具體要完成的項目,再檢查實際的執行結果,確認每一項都完成後,才能把 Goal 標記為 complete。
建立 Goal 時,Codex 會把設定的目標存在 SQLite。每一輪結束後,Codex Harness 會確認 Goal 是否還是 active;如果是,就會執行 Continuation,讓 Model 根據原本的目標和 Continuation Prompt 繼續下一輪工作,直到 Model 確認目標完成,呼叫 update_goal 將狀態改成 complete,才結束 Goal。
做過的事情怎麼變成 Memory?
Codex 的 Memory 分成 Extraction 和 Consolidation 兩個階段。Extraction 負責處理單一 Thread;Consolidation 則從 Extraction 的結果中,再整理出可以重複使用的長期 Memory。
Extraction 會在每次建立新的 Thread 時啟動,找出近期有新增或修改、而且已經閒置一段時間的 Threads,交給 Model 萃取值得留下的內容,再把結果存進本機的 SQLite。已經整理過而且沒有新內容的 Thread 會直接跳過。
Consolidation 接著在 Extraction 後執行,首先依照使用頻率與近期程度篩選出一批內容,再和上一次整理的結果比較。如果有變化,就會啟動專門的 Sub-agent,重新整理長期 Memory。
Memory 在使用時,會先提供一份摘要給 Model,這份摘要最多是 2,500 tokens。當 Model 判斷需要更多細節時,Harness 才會載入相關的 Memory。
Memory 並不是即時同步
Extraction 每次預設最多處理 2 個 Threads,而且這些 Threads 至少要 6 小時沒有新的活動才會被選中。這代表新的對話不會馬上變成 Memory,而且如果前面累積了很多 Threads,後續又沒有建立足夠的新 Threads 來觸發 Extraction,也可能有一部分工作紀錄一直沒有被整理。
Consolidation 預設最多會從 256 份 Extraction 結果中選擇要重新整理的內容,並依照使用頻率與近期程度決定哪些內容優先進入 Consolidation。當 Threads 累積得越多,部分較舊或較少被使用的內容,也就越可能不會進入這一次的長期 Memory 整理。
以上這些數字都是 Codex Memory 的設定值,有需要可以自行調整:
| 設定 | 用途 | 預設 | 範圍 |
|---|---|---|---|
min_rollout_idle_hours | Thread 閒置多久後才可以進入 Extraction | 6 小時 | 1–48 小時 |
max_rollouts_per_startup | 每次啟動 Extraction 最多處理幾個 Threads | 2 | 1–128 |
max_raw_memories_for_consolidation | 每次 Consolidation 最多選入幾份 Extraction 結果 | 256 | 1–4096 |
另外還有兩個會影響 Memory selection 與保留時間的設定:
| 設定 | 用途 | 預設 | 範圍 |
|---|---|---|---|
max_rollout_age_days | Extraction 最多往前找多久以前的 Thread | 10 天 | 0–90 天 |
max_unused_days | 多久沒有被使用的 Memory,不再保留在 Consolidation 的主要 selection 範圍 | 30 天 | 0–365 天 |
最後
看完 Compaction 和 Memory 的機制後,可以看到 Thread 太長或切得太碎都有代價。Thread 太長會更頻繁地觸發 Compaction,除了額外消耗 Token,也會增加早期資訊被簡化或遺漏的風險;但切成大量很短的 Threads,會增加 Extraction 的處理量,也可能更頻繁地觸發 Consolidation。Threads 累積得越多,也越容易碰到 Consolidation 預設上限的問題。
所以我現在會讓一個 Thread 處理一個 Feature 或 Task。碰到比較大的 Feature,我會先拆成多個 Tasks,再交給 Sub-agents 或不同的 Threads 分開處理。如果任務真的很難切開,又需要延續大量上下文,我才會考慮用 Handoff 銜接;對我來說這是最後的手段,不是預設的工作方式。
延伸閱讀
References
- OpenAI Codex: https://github.com/openai/codex
- Model request assembly: https://github.com/openai/codex/blob/main/codex-rs/core/src/client.rs
- Responses request fields: https://github.com/openai/codex/blob/main/codex-rs/codex-api/src/common.rs
- AGENTS.md discovery: https://github.com/openai/codex/blob/main/codex-rs/core/src/agents_md.rs
- Skill metadata rendering: https://github.com/openai/codex/blob/main/codex-rs/ext/skills/src/render.rs
- Compaction: https://github.com/openai/codex/blob/main/codex-rs/core/src/compact.rs
- Remote Compaction: https://github.com/openai/codex/blob/main/codex-rs/core/src/compact_remote.rs
- Goal continuation instructions: https://github.com/openai/codex/blob/main/codex-rs/ext/goal/templates/goals/continuation.md
- Goal state runtime: https://github.com/openai/codex/blob/main/codex-rs/state/src/runtime/goals.rs
- Memory pipeline: https://github.com/openai/codex/blob/main/codex-rs/memories/README.md
- Memory extraction: https://github.com/openai/codex/blob/main/codex-rs/memories/write/src/phase1.rs
- Memory consolidation: https://github.com/openai/codex/blob/main/codex-rs/memories/write/src/phase2.rs
- Memory selection / state: https://github.com/openai/codex/blob/main/codex-rs/state/src/runtime/memories.rs
- Memory configuration: https://github.com/openai/codex/blob/main/codex-rs/config/src/types.rs
- Memory read path: https://github.com/openai/codex/blob/main/codex-rs/ext/memories/src/extension.rs